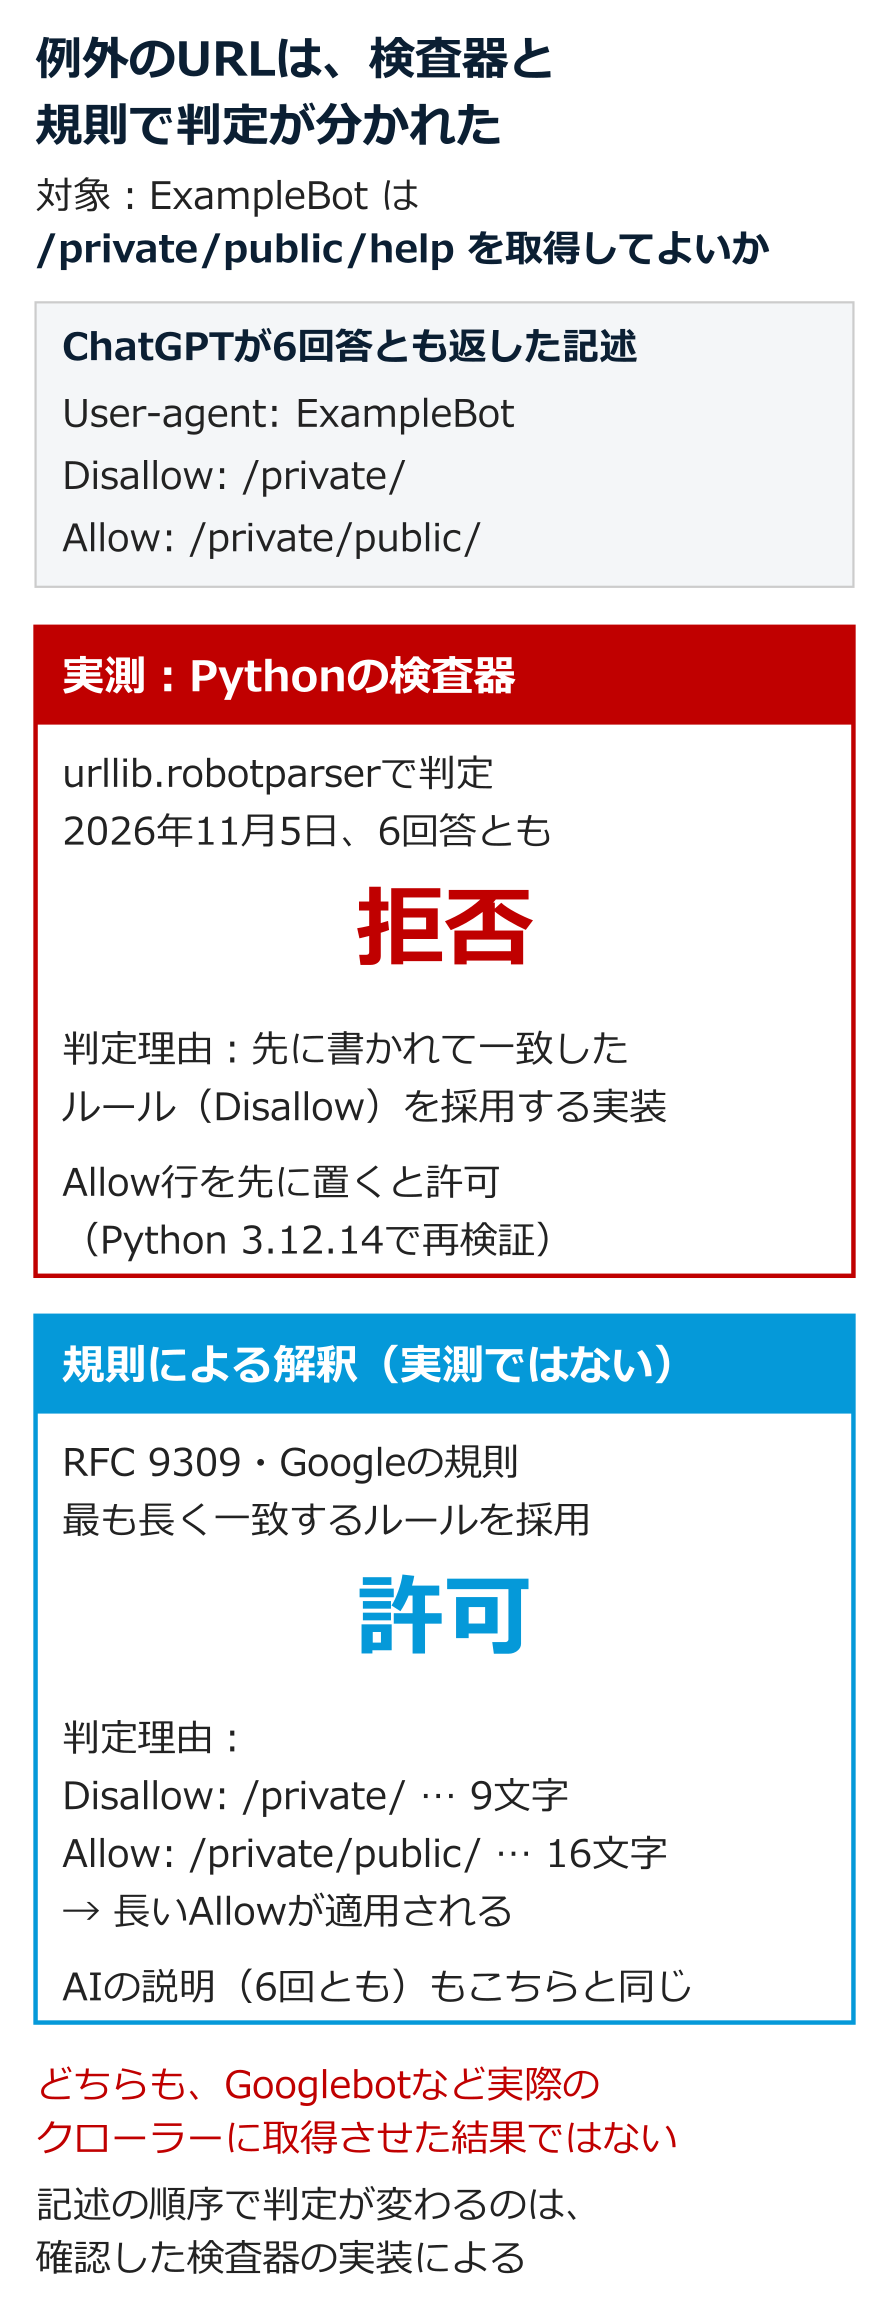
robots.txtは、「どのクローラーに(User-agent)」「どのパスを拒否し(Disallow)」「その中のどこを例外として許可するか(Allow)」を書いて作ります。拒否したディレクトリの一部だけを許可したい場合、RFC 9309とGoogleの規則では、記述の順序ではなく、より長く一致するルールが優先されるため、「Disallow: /private/」と「Allow: /private/public/」を書けば/private/public/配下は許可になります。書く前に、許可・拒否したいURLと期待する判定を表にしておき、書いた後は、制御したいクローラーの優先規則に沿ってURLを1つずつ照合するのが確実です。今回、AIに作らせた記述をPythonの標準ライブラリの検査器にかけたところ、AIが「より長く一致するAllowで許可される」と説明した例外のURLが、6回とも「拒否」と判定されました。原因は、確認した検査器が最長一致ではなく、先に書かれて一致したルールを採用する実装だったことです。RFCとGoogleの規則に照らすと、このURLは許可になり、AIの説明と一致します。手元の検査器の判定を、そのまま正解として扱わないことが大切です。
この記事では、robots.txtの基本的な書き方と優先の規則、AIの生成案を検証する手順、試験で起きた食い違いとその原因を紹介します。
robots.txtの基本の書き方
robots.txtの記述は、主に次の4つの項目で組み立てます(ラクロク ブログ)。
| 項目 | 役割 |
|---|---|
| User-agent | 対象のクローラーを指定する |
| Disallow | クロールを拒否するパスを指定する |
| Allow | 例外的にクロールを許可する |
| Sitemap | サイトマップのURLを記述する |
設定の型としては、すべてのクローラーに特定ディレクトリを拒否する、Googlebotだけに制限をかける、部分的な許可と制限を併用する、といった例が紹介されています(TMS Partners)。また、どのURLに置いたrobots.txtが、どのドメイン・どのパスに対して有効かは、Googleの公式資料に例の表があります(Google 検索セントラル)。CDNなどでファイルを返す場合の例として、Fastlyの資料では、応答の種類にtext/plainを指定し、User-agentとDisallowを少なくとも1つずつ書く手順が示されています(Fastly ドキュメント)。
複数のルールが一致したときの優先順位
同じクローラーのグループの中で、AllowとDisallowの両方が1つのURLに一致することがあります。RFC 9309では、最も長く一致するルール(パスのオクテット数が最も多いもの)を使わなければならない(MUST)とされ、同等に一致するAllowとDisallowではAllowを使うべき(SHOULD)とされています(RFC 9309 §2.2.2)。Googleも、一致するパスの長さで優先を決め、同じ具体性で競合する場合は制限の緩いAllowを採用すると説明しています(Google 検索セントラル:ルールの優先順位)。この規則では、判定を決めるのは記述の順序ではなく一致の長さです。
書き方そのものより迷いやすいのは、「拒否したディレクトリの中の一部だけ許可する」「似た名前のディレクトリを巻き込まない」「特定のクローラーだけに効かせる」といった境界の扱いです。そこでAIに記述を作らせ、境界のURLで意図どおりに判定されるかを確かめました。
AIに作らせて、検査器で判定した
| 項目 | 内容 |
|---|---|
| 要件(合成) | ExampleBotに限り/private/を禁止し、/private/public/は例外として許可する。他のパスとOtherBotは許可する(example.orgを想定した教材用の要件) |
| 条件c1(文章の要件だけ) | 上の要件を渡し「要件を満たすrobots.txtを作り、理由を説明する」よう依頼 |
| 条件c2(代表例を添える) | 同じ依頼に「/private/aはExampleBotに禁止、/news/は許可」という代表例を加えた |
| 使ったAI | ChatGPT(gpt-6.1-sol)。コマンドライン版で毎回新しい会話を開き、記憶・個人設定・Web検索は使わない |
| 回数 | 条件ごとに3回、計6回 |
| 検査 | 生成された記述をPythonの標準ライブラリurllib.robotparserで読み込み、4つのURLの判定を人が決めた期待と照合した。評価用のURLはAIには渡していない。使ったPythonの版は記録していない |
| 実施日 | 2026年11月5日(日本時間) |
比較したのはChatGPTの1モデルだけです。また、検査は手元の検査器による判定で、Googlebotなど実際のクローラーに取得させた結果ではありません。
結果:例外のURLだけ、AIの説明と検査器の判定が食い違った
6回答とも、次の記述を返しました(c2の3回目だけは、最後の「User-agent: *」のまとまりがありませんでした)。
User-agent: ExampleBot
Disallow: /private/
Allow: /private/public/

User-agent: *
Allow: /
AIの説明は6回とも「/private/public/はより長く(より具体的に)一致するAllowによって許可される」というものでした。これを検査器にかけた結果は次のとおりです。
| クローラー | URLのパス | 期待 | 検査器の判定(6回とも同じ) |
|---|---|---|---|
| ExampleBot | /private/x | 拒否 | 拒否(一致) |
| ExampleBot | /private/public/help | 許可 | 拒否(不一致) |
| ExampleBot | /private-archive/x(似た名前のパス) | 許可 | 許可(一致) |
| OtherBot | /private/x | 許可 | 許可(一致) |
似た名前の/private-archive/を巻き込まないこと、ExampleBot以外には効かせないことは、6回ともできていました。食い違ったのは、例外として許可したかった/private/public/helpです。c1とc2で結果は同じで、代表例を添えても、この食い違いは解消しませんでした(代表例に例外のURLは含めていませんでした)。
この食い違いは、検査器の実装と公式の優先規則の違いによるものでした。RFC 9309とGoogleの規則では、/private/public/helpには「Disallow: /private/」と「Allow: /private/public/」の両方が一致し、より長く一致するAllowが適用されるため、許可になります。一方、CPython 3.12の公式ソースでurllib.robotparserを確認すると、ルールを書かれた順に保持し、先頭から見て最初に一致したルールの結果を返す作りで、最長一致を選ぶ処理や、同じ長さのときにAllowを優先する処理はありません(CPython 3.12 robotparser.py)。今回の記述では先にDisallow: /private/が書かれているため、この検査器では拒否になりました。
確認のため、同じ日(2026年11月5日)に元の試験とは別に、保存済みの6回答をPython 3.12.14で再検証しました。元の順序では6件とも拒否、Allow行を先に置いた比較では6件とも許可となり、順序で判定が変わることを再現できました。元の試験で使ったPythonの版は記録しておらず、この再検証の版と同じとは限りません。また、この結果をすべてのPythonの版や、Googlebotなど実際のクローラーが取得した結果として一般化することはできません。
上の表の「拒否」は、この検査器で観測した結果です。RFCやGoogleの規則に照らしてAIの記述が誤っていたという判定ではありません。
想定と違ったこと:AIは「判定表」を自分から出さなかった
企画の段階では、AIに記述と一緒にURLごとの自己判定表も作らせ、検査器と突き合わせる予定でした。しかし実際の依頼文は「記述を作り、理由を説明する」だけで、判定表を求めていませんでした。その結果、6回答ともURLごとの判定表はなく、比較できたのはAIの文章による説明と検査器の出力でした。
6回答とも、/private/public/配下は「より長く(より具体的に)一致するAllowで許可される」と文章で説明していました。c2では、添えた代表例(/private/aは禁止、/news/は許可)を回答の中で繰り返していました。一方で、/private/public/helpのような個別のURLや、似た名前の/private-archive/について、URLごとの判定を表で示した回答はなく、何かで確かめた結果も回答には示されていませんでした。AIに記述を頼むときは、判定表まで依頼し、さらに自分で用意した境界のURLで検査する必要があります。
立場別に見た、生成案の扱い方(仮定)
AIに3つの立場を想定させ、上の結果をどう扱うかを判断させました。以下は実際の担当者の行動ではなく、想定上の判断です。
| 立場(仮定) | 判断 | 次に確かめること |
|---|---|---|
| AIに記述を頼みたいサイト担当者 | 生成案をそのまま本番に置かず、採用を保留する | 許可・拒否したいURLと期待判定を要件表にする |
| 複数ディレクトリを管理するWeb担当者 | 例外URLの不一致を解消するまで適用しない | 末尾スラッシュや似た名前のパスなど、境界のURLを追加して照合する |
| 生成案をレビューする開発担当者 | 生成と検査を同じAIで完結させない | 要件・記述・期待判定・検査器の出力を一表にし、対象クローラーの仕様と検査器の対応範囲を確認する |
3つの立場とも、例外URLの食い違いを確認するまで採用を保留する点で一致しました。
自分で試すための手順
1. 要件表を先に作る
AIに頼む前に、URLごとに期待する判定を決めます。今回の試験で使った表を記入例として示します。
| クローラー | URLのパス | 期待 | 確かめたい理由 |
|---|---|---|---|
| ExampleBot | /private/x | 拒否 | 拒否の基本 |
| ExampleBot | /private/public/help | 許可 | 拒否した中の例外 |
| ExampleBot | /private-archive/x | 許可 | 似た名前のパスを巻き込まないか |
| OtherBot | /private/x | 許可 | 別のクローラーに効いていないか |
自分のサイトでは、ここに末尾スラッシュの有無なども加えておくと、境界の確認が厚くなります(今回の試験では未確認です)。
2. 判定表まで含めてAIに頼む
次の要件を満たすrobots.txtを作ってください。
あわせて、下の各URLについて、各クローラーで許可・拒否のどちらになるかを表で示し、
複数のルールが一致する場合にどれが優先されると考えたかを書いてください。
【要件】(許可・拒否したい対象を書く)
【判定してほしいURL】(要件表のURLを貼る)
3. 対象クローラーの優先規則で照合する
照合の基準は、制御したいクローラーの公式の規則です。Googleが対象なら、要件表の各URLについて、一致するルールのうち最も長いものを選び、同じ長さで競合すればAllowを採る、という規則で判定して期待と比べます。今回の例では、/private/public/helpに「Disallow: /private/」(9文字)と「Allow: /private/public/」(16文字)の両方が一致し、長いAllowが適用されて許可です。
手元の検査器を補助に使う場合は、その検査器が同じ規則で判定するかを先に確かめます。Pythonの標準ライブラリurllib.robotparserは、確認したCPython 3.12では最初に一致したルールを採用するため、Google向けの正誤確認には使えません。次のコードは、今回の食い違い(実装の差)を自分の環境で再現するためのものです。
from urllib import robotparser

def can_fetch(rules, path):
    rp = robotparser.RobotFileParser()
    rp.parse(rules.splitlines())
    return rp.can_fetch("ExampleBot", "https://example.org" + path)

original = """User-agent: ExampleBot
Disallow: /private/
Allow: /private/public/
"""
allow_first = """User-agent: ExampleBot
Allow: /private/public/
Disallow: /private/
"""
for name, rules in [("元の順序", original), ("Allowを先に", allow_first)]:
    print(name, can_fetch(rules, "/private/public/help"))
RFCとGoogleの規則では記述の順序は判定に影響しないため、Allow行を先に書いても意味は変わりません。順序に依存する検査器と結果をそろえたいときの工夫にはなりますが、実際のクローラーでの効き方は次の手順で確かめます。
AIの判定表と検査器の出力が食い違ったら、どちらかを正しいと決めつけず、制御したいクローラーの公式資料で優先の規則を確認します。
4. 本番に置いた後は、対象のクローラー側でも確かめる
検査器での一致は、実際のクローラーの取得や検索への登録を保証しません。Googleについては、URL検査や公開URLテストでクロールが制限されていないかを確かめる手順を公開した記事がGoogleに登録されないときは、何から確認すればよい?にまとめています。公開ページの修正と、登録状態の変化は分けて記録しておくと、原因を追いやすくなります。
分かること・分からないこと
今回分かったのは、合成の要件1つについて、ChatGPT(gpt-6.1-sol)が6回とも同じ形の記述を返し、そのうち例外のURLだけ、AIの説明とurllib.robotparserの判定が食い違ったことです。代表例を添えるかどうかで、この結果は変わりませんでした。食い違いの原因は、RFC 9309とGoogleが最長一致を定めているのに対し、確認した検査器(CPython 3.12)が最初に一致したルールを採用する実装だったことで、Allow行を先に置くとこの検査器でも許可になることを追加の再検証で確かめました。これらは、その条件でのAIの回答と検査器の判定の記録を公開資料と照らし合わせたもので、実際のクローラーの挙動を測ったものではありません。
分からないのは、Googlebotなど実際のクローラーがこの記述で/private/public/helpを取得するか、他のAIやモデルの版で結果が変わるか、元の試験で使ったPythonの版、3.12以外のPythonや他の検査ツールでの判定、です。末尾スラッシュなどの追加の境界URLも試していません。仕様やAIの回答は時期によって変わる可能性があります。
robots.txt以外も含めて点検の順番を整理したい場合は技術SEOは何から確認する?点検の順番と担当者への伝え方を、AI検索への表示が気になる場合はChatGPT検索に自社サイトが出ないとき、何を記録して誰に調査を頼む?も参考にしてください。
参考資料
- Google 検索セントラル(robots.txtの仕様に関する資料)
- Fastly ドキュメント「robots.txt ファイルの作成とカスタマイズ」
- TMS Partners「robots.txtとは?初心者でもわかる設定方法と注意点を完全解説」
- ラクロク ブログ「robots.txtとは?SEOへの影響と書き方・設定方法、注意点を解説」
- RFC 9309「Robots Exclusion Protocol」§2.2.2 The Allow and Disallow Lines
- Google 検索セントラル「How Google interprets the robots.txt specification」ルールの優先順位
- Python公式 CPython 3.12「Lib/urllib/robotparser.py」